一、研究背景与问题设定
在检索场景中,一个查询通常对应上百篇候选文档。这些文档大多包含相关词语,真正能够回答问题的却只占少数;能否将后者排到前列,直接决定用户找到答案所需的等待时间。信息检索领域将对候选结果重新排序的这一环节称为重排序(rerank)。
一种常见实现是让语言模型逐篇阅读候选文档并写出判断理由,再从生成文本中抽取分数。该路线足以完成排序任务,但当最终产物只是一个排序结果时,冗长的自然语言生成并非必要。Jev 提供了另一种思路。该模型由 TypeSafe 开发,面向选择(choice)、评分(rating)与是非判断(yes-no)三类任务设计,直接向调用方返回结构化结果。受这一思路启发,本文尝试以开源模型判定文档与查询的相关程度,并据此重新排列检索结果。
本文检验了两条技术路线:一条是借助通用语言模型理解能力的 TypeLLM-Qwen 方案,另一条是采用专用决策头的 Laya 方案。本组实验既未调用 Jev 服务,也未复现其模型,所考察的问题是与 Jev 同类的决策式判定方法在本地重排序中的可行性。未直接以 Jev 评测,原因是开展本组实验并撰写本文时,作者尚未获得 Jev 的白名单访问权限,本地没有可用的 API 调用凭证。
在本文实验条件下,Qwen 路线的排序质量更高;Laya 在引入判断与比较步骤后,成绩并未随之明显提升。模型是否适合某项任务,需要以其实际排序表现来判断,而不能只依据它能回答哪些类型的问题。
Jev 官方已给出重排序示例。该示例使用法律检索材料,要求模型判断候选段落是否支持某一具体法理,而非仅判断主题是否接近,最后按概率排序;示例基于 Jev 1.12,包含 40 个查询,每个查询保留 30 篇候选[1]。这一做法把模糊的相关性转写为明确标准:在知识库问答场景中,“文档提到了某个概念”与“文档提供了问题所需的答案”理应获得不同评价,因此程序必须向模型指明当前要求的是哪一种判断。
Jev 提供三类判断方式:choice 用于在候选项中挑出较合适者,rating 用于区分程度,yes-no 返回条件成立的概率。同一份材料可以对应多个问题,但这些问题相互独立作答,彼此看不到对方的答案;先筛选、再复核的多阶段流程仍需由程序编排[2]。官方资料还介绍了其专用架构与强化学习训练,训练目标同时包含判断质量与概率校准(calibration)[3]。所谓校准,关注的是模型报告的概率与实际正确情况能否对应;输出中带有百分比,并不足以说明该概率可靠。
本文实现借鉴了上述输入与输出的组织方式:将查询、文档与评价标准一并提供给模型,仅允许其在预先规定的答案集合内作答,再由程序计算分数。这种共性并不意味着两类系统采用了相同的模型结构或训练方法。
此外还须区分相关程度与把握程度。Jev 的 choice 与 rating 会给出置信度(confidence),用于概括模型自身判断的集中程度[4]。模型可能很有把握地判定某篇文档不相关,因此重排序应当依据相关性,而不能把置信度高的文档一律前置。
二、方法:把相关性判定转化为可计算的打分问题
本节介绍的两类实现都让模型在限定范围内给出相关性判断,再由程序把答案换算为分数;区别在于决策的计算方式与提问的组织方式。
Qwen3.5-4B 的期望等级打分
实验使用的模型为 Qwen3.5-4B,参数量约 4B[9]。相关性分为四个等级:0 分表示不相关;1 分表示主题接近但无法有效回答问题;2 分表示提供部分答案;3 分表示直接且充分地回答问题。
程序不要求模型输出自然语言评语,而是读取模型对四个等级分别给出的概率,据此计算期望等级(expected grade):模型对高等级的倾向越强,文档的最终得分越高。开源工具 TypeLLM 负责定义可选答案,并将四个等级映射为 A、B、C、D 四个控制标签(control label)[11]。每个控制标签均可由单个 token 表示,因此程序能够直接读取模型在答案位置对这些标签的偏好。
实际计算在本地 Transformers 后端完成:程序取出四个控制标签的 log-probabilities,以 FP32 精度换算为概率并使其总和为 1,再按等级加权求和。该做法保留了模型判断中的不确定性,同时省去了从自然语言文本中抽取评分的步骤。
这些概率仅在四个候选等级内部归一化,尚不能视为经过校准的真实相关概率。
评分时每次只向模型提供查询、评价规则与当前文档,人工标注的相关性答案保留在评测程序中,不进入模型输入。程序保存 prompt、标签、logits 以及逐查询成绩,排序使用未按显示精度舍入的分数,以便复核。
Laya 决策头与多种提问方式
Laya 的计算路径不同。先整体读取输入文本,再通过专门的决策头(decision head)为各选项评分,无需生成长篇回答[10]。每个选项在输入中对应一个 special token,模型根据该 token 位置的表征计算分数,再换算为选项概率。
三个版本分别为英文版、多语言版与 typed-decisions 版,参数量约为 322M 至 421M。下文将 typed-decisions 版简称为决策版。三个版本与 Qwen 在模型规模与训练数据上均存在差异,因此本文的比较结果不能单独证明哪种模型结构更优。
针对 Laya,第一种问法是四等级评分,沿用与 Qwen 相同的相关性标准;第二种是“有无”判断,即只询问文档能否提供有用信息,并按模型回答“有”的概率排序。第三种把相关性拆解为三层问题:文档是否至少与主题相关、是否提供有用信息、是否直接且充分地回答问题。将三者的肯定概率相加,即得到本文所称的三问评分。
三问评分需要付出更高的计算代价。在本地实现中,同一篇文档的三个问题分别构成三条输入,模型仍须逐条读取;即便这三条输入合并在同一个 batch 中处理,也不等于模型只阅读了一遍文档。
成对复核与截断对照
在三问评分之外,还尝试了成对复核(pairwise):在前十篇文档中选取分数接近且位置相邻者,最多比较五对;每对交换前后顺序各询问一次,合并两次判断后,只有当原本靠后文档的胜出概率超过 0.60 时才交换位置。每个查询至多因此增加十次判断。
成对复核要求缩短每篇文档的文本,为观察截断(truncation)的影响,另设一组短文对照,对同一批文档使用短文本重新逐篇评分。由于短文对照与成对复核采用了不同的交换门槛,该设计仍无法完全分离文本长度与判断方式各自的影响。以上方法均未重新训练模型。
三、评测协议(数据、指标、候选集、生成参数)
评测采用 TREC Deep Learning Track 的两组英文段落数据,分别来自 2019 年与 2020 年,包含 43 个与 54 个查询[12–14]。其中 2019 年数据用于方法开发与检查;2020 年数据在方法固定之后用作测试集,未再依据测试结果挑选 prompt 或调整参数。
每个查询使用 BM25 预先检索出的 100 篇候选文档,候选集来自公开数据仓库[15]。模型的作用限于调整这批文档的排列顺序。评价针对前十条结果,采用 nDCG@10 指标,该指标同时考虑文档的相关程度与其所处位置;数值越高表示排序质量越好,但不能解释为答对问题的百分比。
各模型采用相同的截断方式与相关性判定规则;生成时控制概率分布的温度固定为 1,Qwen 关闭 thinking(思维链)模式。由于每个模型保留各自适用的 prompt 模板,本文比较的是完整系统的表现,而非单一组件。
四、实验结果
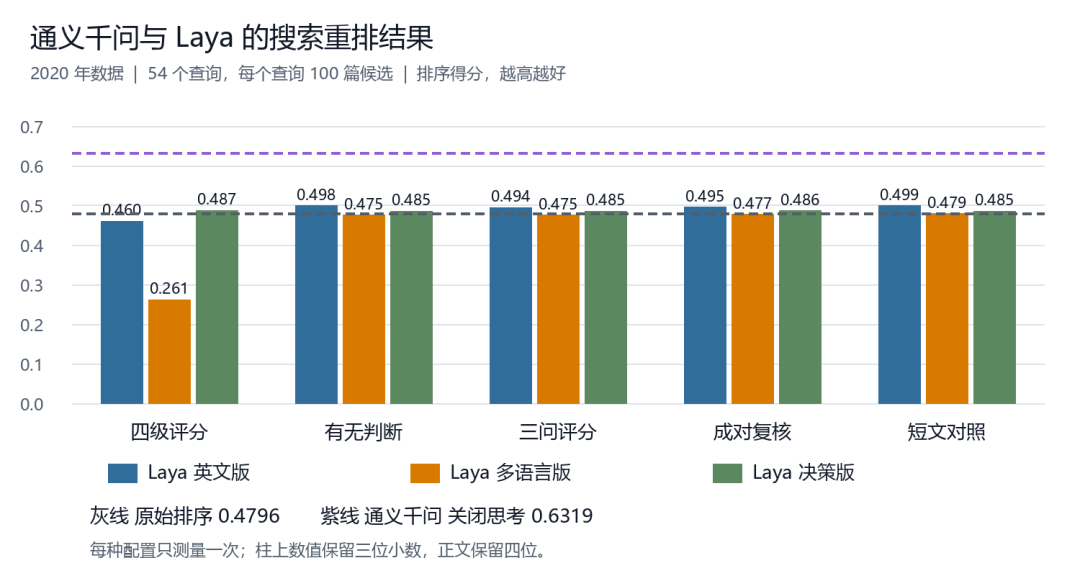
图 1 2020 年测试集上的 nDCG@10。横线分别标出原始排序与 Qwen 的成绩;Qwen 关闭 thinking,温度统一为 1,Laya 每批处理一条输入。
在 2020 年测试集上,原始排序的 nDCG@10 为 0.4796,Qwen 提升至 0.6319。Laya 英文版的“有无”判断为 0.4983,短文对照为 0.4988,较原始排序高约 0.019;决策版五种方法的成绩集中在 0.4850–0.4870 之间。
多语言版的差距更为明显,其四等级评分仅为 0.2615,而“有无”判断与三问评分则达到约 0.475。各配置所用的模型与候选文档相同,只有提问方式不同,排序结果就出现明显差别。
但简单问法并非总是更优,决策版的四等级评分为 0.4870,略高于该版本的“有无”判断。因此,适合某一模型的提问方式,不能直接推广到其他模型。
在 2019 年数据上,Qwen 得到 0.6927,原始排序为 0.5058,而所有 Laya 配置均低于原始排序。因此,在本文实验条件下,尚不能认为 Laya 能够稳定改善检索结果。
上述配置均只测量一次,尚未验证重复运行带来的波动,不能据此宣称达到行业最好水平。重排序还存在一项直接限制:只有正确答案已进入候选集,模型才有可能将其排到前列。
五、思维链与成对复核的边际收益(含概率单调性违例)
实验还考察了 Qwen 开启思维链后的表现:模型先生成思考内容,再判断相关性。该组测试使用 2019 年的 43 个查询,每个查询仍保留 100 篇候选,每种配置执行一次。
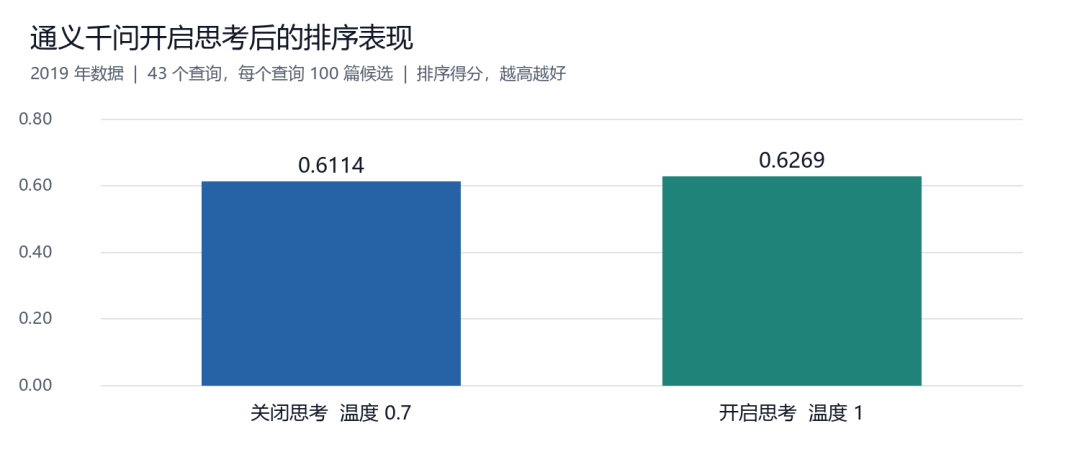
图 2 Qwen 两种配置(关闭/开启 thinking)的 nDCG@10。除 thinking 开关外,温度与运行流程亦有变化。
关闭思维链时成绩为 0.6114,开启后为 0.6269。后者数值更高,但不应把差值全部归因于思维链:两种配置的温度分别为 0.7 与 1.0,并非只改变了一个条件。该组测试所用 prompt 与运行流程也与图 1 不同。因此,该结果只能说明两套完整配置之间的成绩差异,尚不足以回答单独开启思维链能够带来多大提升。
实验将三问评分与叠加成对复核后的成绩并列比较,观察额外判断带来的收益。让两篇文档同时进入模型输入,有望借此分辨差异,实际效果仍待数据检验。
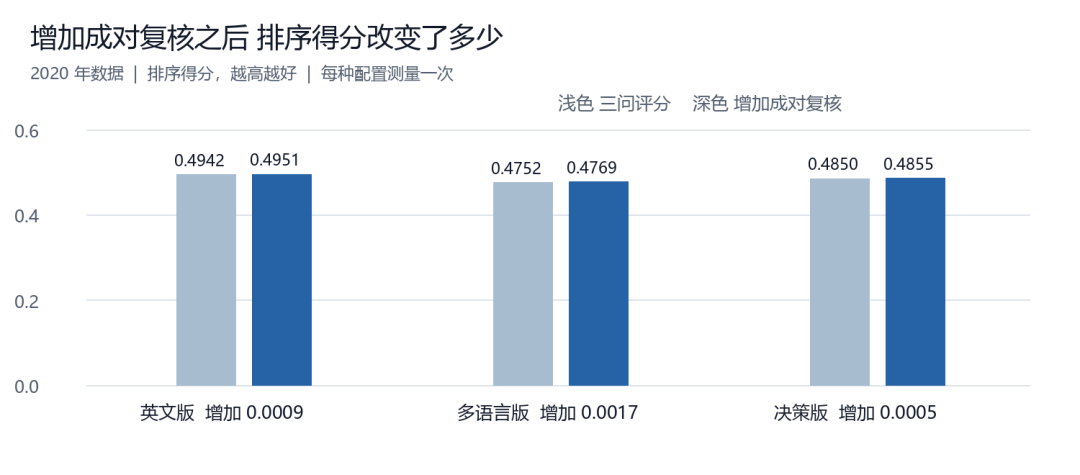
图 3 2020 年测试集上增加成对复核前后的 nDCG@10。差值不代表已验证的稳定收益。
英文版从 0.4942 变为 0.4951,仅增加约 0.0009;多语言版增加约 0.0017,决策版增加约 0.0005。按查询对英文版与决策版做统计比较后,二者差值的置信区间均包含零,现有数据尚不能排除“没有提升”的可能。该检验反映的是查询样本层面的不确定性,不能替代重复运行测试。
额外比较确实改变了部分排名:三个版本分别比较了 222、224、223 对文档,交换了 35、48、21 对的位置。然而,位置交换本身并不意味着正确内容被排到了更前面。
三问评分还显示,模型的回答并不一致。按问题含义,一篇能够充分回答问题的文档应当提供有用信息,并至少与主题相关;但模型分别作答时,较严格条件给出的肯定概率经常高于较宽松条件,即违反单调性(monotonicity)。在 2020 年测试集上,英文版、多语言版与决策版出现至少一处此类概率倒挂的比例分别约为 89.4%、86.7%、92.7%。这些数字反映的是模型回答之间的不一致程度,而非排序错误率。
三个概率之和可以作为排序分数使用,却不能直接解释为严格意义上的相关等级概率;交换两篇文档的展示顺序,也只能用于检查与减轻位置偏差(position bias),无法保证偏差消失。Jev 官方资料同样提示,独立提问不保证概率之间满足互补等关系[5]。模型的错误来源未必相同,但要求严格成立的规则,仍须由程序检查。
六、批处理吞吐与数值一致性
检索服务还需考虑响应时延。三问评分处理 100 篇文档需要计算 300 条输入;将多条输入集中提交 GPU 计算,通常称为批处理(batching)。本地测试比较了每批一条与每批三十二条两种设置。
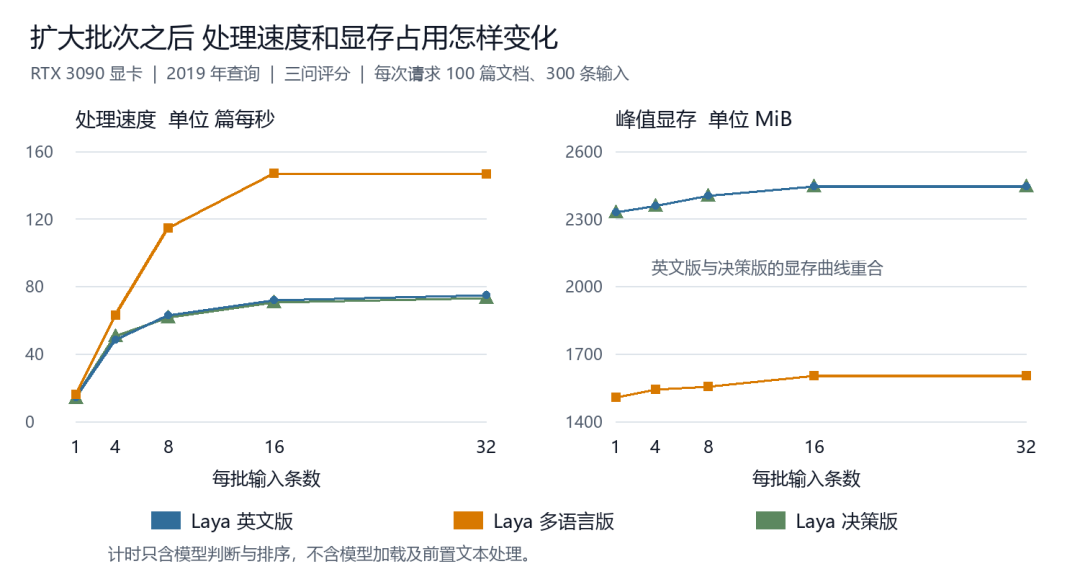
图 4 每批输入数量对处理速度与显存占用的影响。使用 2019 年查询与三问评分,每次请求处理 100 篇文档;计时不含模型加载与前置文本处理,英文版与决策版的显存曲线重合。
英文版的处理速度从每秒约 14.1 篇提升至约 74.9 篇;多语言版在每批三十二条时达到每秒约 146.7 篇。折线显示,扩大批次的效果并不一致:多语言版从每批十六条增至三十二条时,处理速度已接近持平。
但改变每批数量还会影响输出数值。测试采用节省显存的 BF16 精度,改变每批数量后,部分输出的数值差异超过预设容差,文档名次随之发生变化。因此,正式质量测试固定每批一条,较大的批次仅用于测量工程性能;不能把图中的较快速度与另一配置的质量成绩拼接成一个部署结论。
图中的计时只是用户实际等待时间的一部分:文本转换为模型输入的步骤发生在计时之前,真实服务还须计入请求排队、网络传输与首次加载模型的耗时。这组数据来自本地 Windows 计算机与一张 RTX 3090 GPU,未调用在线收费服务。
对外 API 可以保持简单:接收问题、候选文档与希望返回的条数,输出文档位置与相关性分数。内部更换模型后,分数所代表的含义仍需说明清楚。后续还需检验数值精度、按文本长度分组处理,以及超时后回退至原始排序等做法。
七、应用场景与适用边界
在搜索之外,只要任务能够给出候选与判断标准,就可以考虑采用类似 Jev 的决策方式。这些场景中,有的是官方示例,有的是应用设想;本次本地测试仅覆盖检索重排序。
输入法即是一种可能场景。拼音、词频与用户词库给出候选词,模型结合前文判断哪个词更符合语境。不必每次按键都做该判断,可以只在短语边界或候选歧义较大时触发;超过等待时限则保持原有顺序。输入法场景尚未在本项目中测试,也未核实到 Jev 的官方实测结果。其是否值得采用,取决于首选词命中率、翻页次数与改选次数,还须考察较慢请求的等待时间、内存占用、能耗与隐私处理。英文检索的成绩不能用于证明中文输入场景的效果。
智能路由(routing)已有官方示例:Jev 从 182 项技能中筛选,先排序并判断是否需要技能,再读取前三项的详细说明并重新选择,也允许全部拒绝[6]。排名第一的工具仍可能无法完成任务,因此选择之后还须判断其是否适用。知识库分流与模型选择可以借鉴这一流程:收到问题后,系统判断应直接回答、查询资料、调用工具,还是交给更强的模型或人工处理。费用、等待时间与权限由程序检查,效果则以任务成功率、错误调用率与总成本衡量。
文档抽取的官方示例同样让程序与模型分工:先按文本规则找出邮箱、电话与金额,再由 Jev 选择符合要求的值,由程序从原文复制并整理格式;若没有合适的候选,则返回空结果[7]。该设计避免了重新生成数字,却不能避免选错值,更无法找回被规则漏掉的候选。知识库问答还可增加引用核验,官方示例先检查引文是否出现在原文中,再判断上下文是否支持回答的结论[8]。某句话确实存在,并不代表回答对它的解释正确;该检查安排在生成之后,与生成之前的重排序分开评估。
Jev 1.13 的官方说明也列出了数值运算、多步推理、无关上下文与恶意输入等局限[5]。金额计算、日期比较与权限校验应交给代码处理;退款、删除与外发信息等操作仍需相应授权,不能由模型的选择结果代替。
八、结论与局限
在本文实验条件下,以决策式模型替代生成式输出的重排序思路可以在本地实现。基于 Qwen3.5-4B 的期望等级打分方案在两组段落数据上均优于原始 BM25 排序,其中 2020 年测试集的 nDCG@10 达到 0.6319,2019 年数据上达到 0.6927;各 Laya 配置的改善有限,在 2019 年数据上甚至普遍低于原始排序。在成对复核与思维链方面,本文观察到的边际收益很小,且相关对比并非单变量实验。
本文的结论受限于若干条件。所有配置均只运行一次,未评估重复运行带来的波动,因而不能宣称其结果达到最优或行业最好水平。重排序依赖候选集的召回能力:正确答案若未进入 BM25 前 100 篇,模型无法将其排到前列。三问评分存在明显的概率单调性违例,且期望等级所用概率仅在选项内部归一化,不构成经过校准的置信度。批处理虽提升吞吐,但在 BF16 下引入数值差异并改变名次,速度与质量不可跨配置拼接。思维链对比同时改变了温度与运行流程,成对复核与短文对照使用了不同的交换门槛,相关差异无法完全归因。Laya 与 Qwen 在模型规模与训练数据上不同,比较结果不能单独支持关于模型结构的结论。本文仅覆盖英文段落检索场景,硬件环境为一台配备单张 RTX 3090 的本地 Windows 主机。
本文为个人实验记录,结论仅适用于文中描述的实验条件;文中数据来自本地测试,不代表任何厂商立场。
参考资料
TypeSafe 官方资料
[1] Jev 搜索 rerank 示例。https://docs.typesafe.ai/cookbooks/rerank_typesafe
[2] Jev 接口与判断方式。https://docs.typesafe.ai/introduction
[3] Jev 模型与训练思路。https://typesafe.ai/blog/introducing-system-one-models-and-jev
[4] 置信度的含义与使用。https://docs.typesafe.ai/confidence
[5] Jev 1.13 的已知局限。https://docs.typesafe.ai/model-jaggedness/jev-1.13
[6] 智能体技能选择示例。https://docs.typesafe.ai/cookbooks/skill_suggestion
[7] 从文本候选中抽取字段。https://docs.typesafe.ai/cookbooks/pre_parsed_value_extraction_cookbook
[8] 回答引用的核验方法。https://docs.typesafe.ai/cookbooks/citation_check
模型与项目
[9] Qwen3.5-4B 模型主页。https://huggingface.co/Qwen/Qwen3.5-4B
[10] Laya 模型主页。https://huggingface.co/convaiinnovations/laya
[11] TypeLLM 开源项目。https://github.com/TypeLLM/TypeLLM
数据集引用
[12] 2019 年检索评测引用。Craswell, N., Mitra, B., Yilmaz, E., Campos, D., & Voorhees, E. M. (2020). Overview of the TREC 2019 deep learning track. arXiv:2003.07820 https://arxiv.org/abs/2003.07820
[13] 2020 年检索评测引用。Craswell, N., Mitra, B., Yilmaz, E., & Campos, D. (2021). Overview of the TREC 2020 deep learning track. arXiv:2102.07662 https://arxiv.org/abs/2102.07662
[14] 基础语料引用。Bajaj, P., et al. (2016, revised 2018). MS MARCO: A Human Generated MAchine Reading COmprehension Dataset. arXiv:1611.09268v3 https://arxiv.org/abs/1611.09268v3
[15] 候选数据来源。Castorini 的 rank_llm_data 数据仓库,本文使用其中的 BM25 前 100 篇段落候选。https://huggingface.co/datasets/castorini/rank_llm_data
